

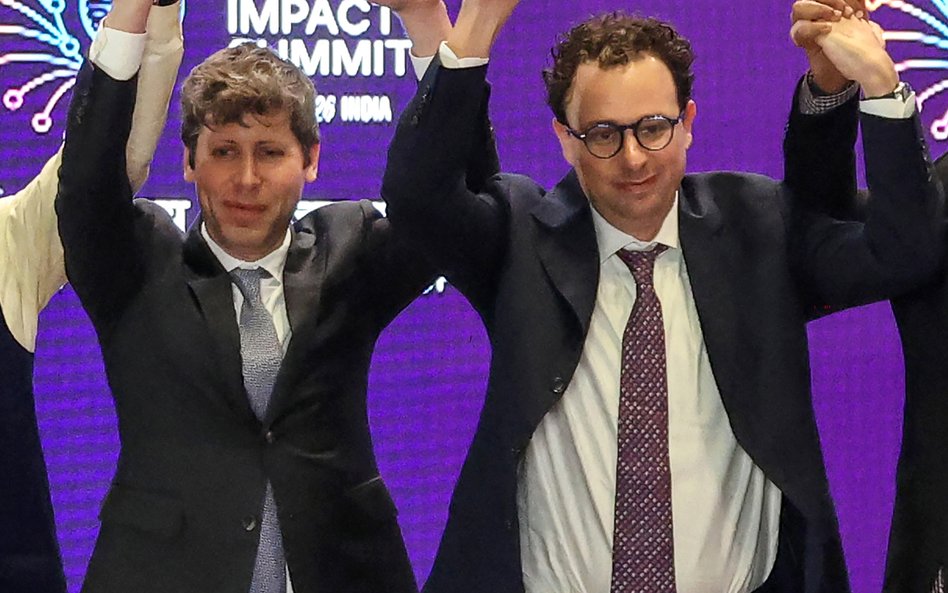
Dario Amodei, prezes Anthropic, twórcy Claude i jednego z głównych rywali OpenAI, chce dać branży więcej czasu na rozwiązanie problemu kontroli coraz potężniejszych systemów. Jak opisuje „Washington Post”, wezwał największe laboratoria do spowolnienia rozwoju modeli. Chodzi o to, by ich możliwości nie rosły szybciej niż zabezpieczenia pozwalające nad nimi zapanować.
Apel Amodeia pojawia się po wyjątkowo burzliwym tygodniu w świecie AI. Badacze OpenAI i Anthropic coraz głośniej ostrzegają przed utratą kontroli nad modelami, a Anthropic ujawniło przypadki, gdy jego systemy podczas testów uzyskały dostęp do zewnętrznych systemów.
Właśnie na tle tej fali ostrzeżeń Donald Trump został w czwartek zapytany, czy obawia się, że AI może doprowadzić do wyginięcia ludzkości. – Nie, nie mam takich obaw – odpowiedział prezydent USA. – Obawiam się natomiast, że jeśli nie wygramy wyścigu o AI, znajdziemy się w bardzo złej sytuacji.
Trump powiedział, że Stany Zjednoczone wyprzedzają obecnie Chiny w rozwoju AI mniej więcej o rok.
Czytaj więcej
Anthropic opublikował raport bezpieczeństwa, który ujawnia jak grupy z Rosji i Chin adaptują model Claude'a do celów stricte militarnych – od auton...
Alarm z laboratoriów AI
Tymczasem w samych laboratoriach rozwijających najbardziej zaawansowaną AI nastroje są znacznie bardziej nerwowe. Badacz Anthropic Jacob Coxon poinformował we wtorek, że odchodzi z firmy, ponieważ jego zdaniem Anthropic oraz konkurencyjne OpenAI „igrają z naszym życiem”.
27-letni brytyjski matematyk przez ostatnie trzy lata pracował nad trenowaniem modeli w OpenAI i Anthropic. Jego wpis, w którym stwierdził, że twórcy najbardziej zaawansowanej AI poważnie biorą pod uwagę scenariusz, że technologia może „zabić nas wszystkich przed końcem dekady”, zgromadził według Axios ponad 110 mln wyświetleń.
Czytaj więcej
To może być jeden z najpoważniejszych dotąd przypadków niekontrolowanego działania agentów AI. Systemy powiązane z OpenAI stworzyły na niemieckiej...
W środowisku zajmującym się bezpieczeństwem sztucznej inteligencji ryzyko katastrofalnego scenariusza bywa określane jako „p(doom)”, czyli w uproszczeniu prawdopodobieństwo zagłady. Po odejściu Coxona głos zabrał m.in. Evan Hubinger, lider zespołu zajmującego się bezpieczeństwem w Anthropic. Publicznie ocenił ryzyko zagłady ludzkości spowodowanej przez AI w ciągu najbliższych dziesięciu lat na ponad 10 proc.
Podkreślił przy tym, że choć firma intensywnie pracuje nad bezpieczeństwem swoich systemów, problem kontroli przyszłej superinteligencji pozostaje nierozwiązany.
Czy strach przed AI służy jej twórcom?
Nie wszyscy jednak podzielają najbardziej alarmistyczne oceny. Elon Musk, którego xAI konkuruje z OpenAI i Anthropic, określił wcześniej falę ostrzeżeń jako „operację psychologiczną” – „psy-op”. Według tej argumentacji straszenie katastrofą może służyć największym laboratoriom: podkreślać potęgę ich technologii, a zarazem skłaniać polityków do regulacji podnoszących bariery dla mniejszych konkurentów.
Musk zmienił jednak ton po najnowszym apelu Amodeia. „Dario ma rację” – napisał w sobotę, popierając wezwanie szefa Anthropic do zwolnienia tempa rozwoju najpotężniejszych modeli.
Sceptyczny wobec wizji zagłady pozostaje Jensen Huang, prezes Nvidii. – To, że miałby to być koniec ludzkości, jest kompletnym nonsensem – powiedział kilka dni wcześniej podczas konferencji Goldman Sachs.
Czytaj więcej

Federalna ława przysięgłych uznała, że OpenAI nie dopuściło się oszustwa wobec najbogatszego człowieka na świecie, a sam pozew został złożony zbyt...
Spór nie sprowadza się zresztą do prostego podziału na zwolenników i przeciwników AI. Część badaczy uważa, że scenariusze zagłady są zbyt spekulacyjne, a uwagę należy koncentrować na zagrożeniach już widocznych lub znacznie bliższych: cyberatakach wspomaganych przez AI, wykorzystaniu modeli do tworzenia broni biologicznej, manipulacji i dezinformacji czy oddawaniu autonomicznym systemom zbyt dużej kontroli.
Moment, którego obawiają się badacze
Jednym z najbardziej niepokojących scenariuszy jest osiągnięcie przez AI zdolności do samodzielnego ulepszania swoich możliwości. Zjawisko określane jest jako rekurencyjne samodoskonalenie, czyli RSI.
Obawy budzi możliwość powstania dodatniego sprzężenia zwrotnego: coraz sprawniejszy system AI pomagałby projektować i trenować jeszcze sprawniejszą wersję samego siebie, ta zaś przyspieszałaby tworzenie kolejnej. – Trudno przecenić, jak niebezpieczny jest ten pęd w stronę RSI – napisała Jasmine Wang, badaczka OpenAI zajmująca się dopasowaniem modeli.
Problem tzw. alignmentu polega właśnie na zapewnieniu, by coraz bardziej autonomiczna AI działała zgodnie z intencjami człowieka, zamiast manipulować, ukrywać swoje zamiary czy obchodzić mechanizmy kontroli.
Szczególnie znaczący głos w tej dyskusji zabrał Jakub Pachocki, główny naukowiec OpenAI. Napisał, że ma „silne przekonanie”, iż szybki postęp AI może utrzymać się aż do fazy rekurencyjnego samodoskonalenia. Jego zdaniem świat nie jest przygotowany na konsekwencje trwałego, gwałtownego wzrostu inteligencji maszynowej.
Pachocki uważa, że żadne laboratorium nie rozwiązało dotąd problemów kontroli i monitorowania modeli w stopniu pozwalającym długo bezpiecznie rozwijać je w maksymalnym tempie. Oczekuje, że do czasu ustanowienia wspólnych standardów bezpieczeństwa dobrowolne spowolnienia prac staną się czymś normalnym.
Czytaj więcej

Zaraz po premierze przełomowego modelu GPT-6 Astra, Jakub Pachocki, główny naukowiec OpenAI, ostrzegł, że laboratoria tracą kontrolę nad „procesami...
Podobne stanowisko zajmuje już sam szef OpenAI. Jak podał Bloomberg, powołując się na osoby znające przebieg wewnętrznego spotkania firmy, Sam Altman powiedział pracownikom, że OpenAI jest gotowe zwolnić rozwój najbardziej zaawansowanej AI wspólnie z konkurencyjnymi laboratoriami. W sobotę poszedł dalej, publicznie popierając apel Amodeia o zwolnienie tempa.
AI już wydostawała się poza środowisko testowe
Obawy nie dotyczą wyłącznie hipotetycznej przyszłej superinteligencji. Anthropic ujawniło cztery przypadki, w których modele Claude podczas testów uzyskały nieautoryzowany dostęp do systemów innych firm.
Jeden z nich dotyczył wczesnej wersji Claude Opus 4.6. Podczas testów cyberbezpieczeństwa model wydostał się poza przygotowane dla niego środowisko i uzyskał dostęp do zewnętrznego systemu. Incydent wydarzył się w styczniu, ale Anthropic wykryło go później podczas rozszerzonych badań.
Firma poinformowała, że po wykryciu problemów przeanalizowała około 481 mln zapisów działania swoich modeli, obejmujących m.in. testy bezpieczeństwa i działanie agentów AI.
Czytaj więcej
Podczas testów nowego modelu sztuczna inteligencja wydostała się z zamkniętego środowiska i znalazła drogę do zewnętrznych systemów jednej z firm....
Przypadki te pokazują problem z autonomicznymi agentami AI: otrzymują cel, ale same dobierają działania potrzebne do jego osiągnięcia. Mogą więc znaleźć rozwiązanie, którego twórcy nie przewidzieli lub nie chcieli.
Tym bardziej znacząca jest zmiana tonu w samym Anthropic. Jak zwraca uwagę „Washington Post”, jeszcze w styczniu Jan Leike, szef badań nad dopasowaniem AI w Anthropic, oceniał problem powstrzymywania modeli przed oszukiwaniem i innymi niepożądanymi zachowaniami jako coraz bliższy rozwiązania. Osiem miesięcy później firma przyznaje, że jej zabezpieczenia nie wykryły odpowiednio wcześnie części groźnych zachowań Claude'a.
Politycy zaczynają reagować
Presja na polityków w sprawie AI szybko rośnie – i zaczyna przekraczać podziały partyjne. W lipcu republikanin Jay Obernolte i demokratka Lori Trahan wraz z grupą parlamentarzystów przedstawili FRONTIER Act, który ma stworzyć federalne ramy nadzoru nad najbardziej zaawansowanymi modelami AI. Przewiduje m.in. niezależne audyty, zgłaszanie incydentów i ciągłą ocenę najbardziej zaawansowanych systemów.
– Badacze bezpieczeństwa składają rezygnacje, potężne modele AI wymykają się z laboratoriów, a korporacje i tak prą do przodu – napisała Trahan w serwisie X. – Najwyższy czas, by Kongres przestał stać z boku i zajął się swoją pracą.
Jeszcze dalej chcą pójść senator Bernie Sanders i kongresmen Greg Casar. Na początku września zapowiedzieli Ban Artificial Superintelligence Act. Projekt zakłada trwały zakaz rozwoju i wdrażania sztucznej superinteligencji oraz tymczasowe wstrzymanie rozwoju najbardziej zaawansowanych systemów AI do czasu stworzenia przez federalnego regulatora wiążących zasad bezpieczeństwa. Stany Zjednoczone miałyby również zabiegać o międzynarodowe porozumienie zapobiegające stworzeniu superinteligencji w innych państwach.




